← Writing技术分享
大模型 KV Cache
·1 min read·181 words·updated August 3, 2025· KV-Cache#
KV-Cache是目前Transformer常用的功能,应用于Decoder架构的推理加速。
Self-Attention 不带KV-Cache流程#
以下流程来自知乎看图学[1]
对于一段文字输入,有以下计算过程:
- 首先输入一个token的embedding,大小为[1, emb_size]
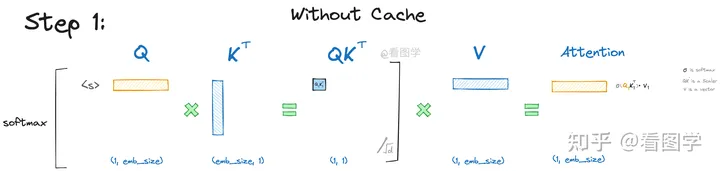
经过公式计算得出attention向量,这里为方便表示d被省略
Att1(Q,K,V)=softmax(dQ1,K1T)V→
- 输入第二个token
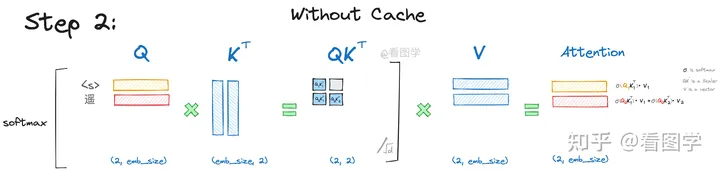
在这里可以发现,attention的计算公式为:
Att2(Q,K,V)=softmax([Q1K1T−∞Q2K1TQ2K2T])[V1→V2→]=([softmax(Q1K1T)V1→+0softmax(Q2K1T)V1→+softmax(Q2K2T)V2→])
因此可以发现:
Att1(Q,K,V)Att2(Q,K,V)=softmax(Q1K1T)V1→=softmax(Q2K1T)V1→+softmax(Q2K2T)V2→
随后的attention也同理可得
Atti(Q,K,V)=j=1∑isoftmax(QiKjT)Vj→
因此可以得出结论:
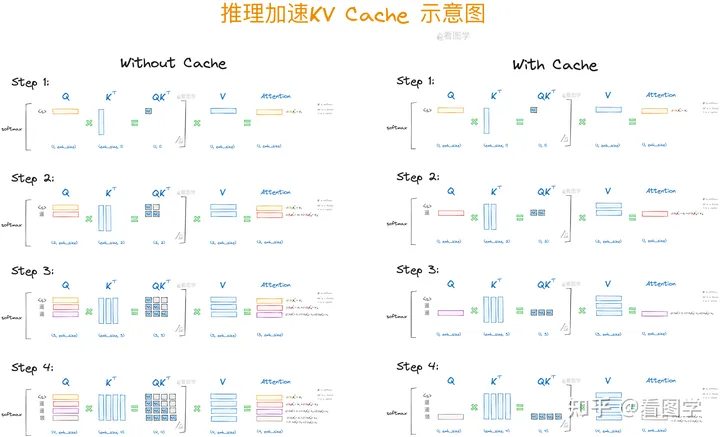
- 当前计算方式存在大量冗余,计算量可以优化
- Attention只与Qk相关
- 推理第i个字符只需要i-1即可
推理加速示意图#
引用:#
[1] https://zhuanlan.zhihu.com/p/662498827